随着 IFA 2026 落下帷幕,端侧 AI 的竞争正式进入白热化阶段。英伟达推出面向 PC 的 RTX Spark 芯片,AMD 则祭出统一内存高达 192GB 的 Gorgon Halo 应战,两家巨头不约而同地把目标指向同一个方向——让千亿参数大模型在本地设备上流畅运行。
端侧 AI 为何成为新的战场
AI PC 线上市场渗透率已突破 52%,Counterpoint 预计 2026 年高端 AI PC 出货渗透率将从 2025 年的 39% 升至 59%。行业走过”概念走红、参数比拼”的阶段后,用户开始追问:这些算力到底能在自己的电脑上做成什么?这正是端侧 AI 芯片大战的起点。
英伟达 RTX Spark:1 PFLOPS 的迷你 AI 主机
RTX Spark 将 20 核 Grace CPU 与 6144 个 CUDA 核心的 Blackwell RTX GPU 通过 NVLink-C2C 互连为一体,FP4 精度下 AI 算力达到 1 PFLOPS,最高支持 128GB 统一内存,可本地运行 1200 亿参数、100 万 token 上下文的大模型。搭载该芯片的紧凑型主机与轻薄本将于 10 月上市,宏碁、联想等 6 家 OEM 厂商率先跟进。
AMD Gorgon Halo:192GB 内存剑指 3000 亿参数
AMD 新一代 Gorgon Halo 把统一内存从 128GB 提升到 192GB,官方宣称可在本地部署 3000 亿参数模型,直接对标英伟达 DGX Spark。AMD CEO 苏姿丰多次表示”AI 才进行到第三局”,并预测 2030 年全球活跃 AI 用户将从 10 亿增至 50 亿。
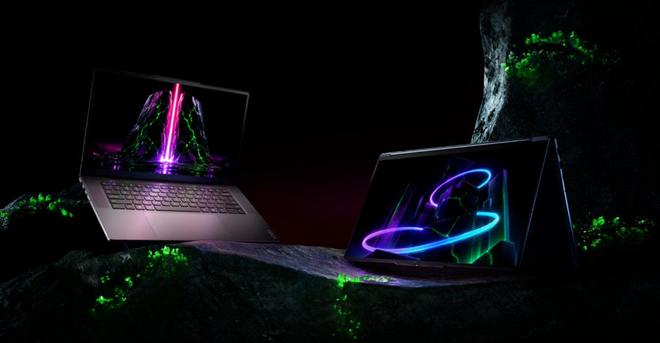
联想 Yoga Pro 9n:千亿参数模型装进 16.7mm 笔记本
联想与英伟达深度合作的 Yoga Pro 9n(国内型号 YOGA Pro 15 Spark)是端侧 AI 落地的代表作:一台 16.7 毫米厚的笔记本即可本地运行千亿参数大模型。联想 AI PC 全球市场份额已达 25.1%,在同行纷纷降调的背景下选择继续加码端侧投入。
开源利器 PAIR:让本地多台电脑协同推理
英伟达同时开源了 Personal AI Router(PAIR)技术,可在本地网络的多台电脑之间智能分配 AI 推理任务:当多台设备同时请求推理时,PAIR 会自动将独立请求路由到算力空闲的机器,兼容 Ollama、LM Studio,支持 RTX 20 系及更新 GPU、RTX PRO 桌面卡与苹果 M4 及以上芯片。
端侧 AI 的意义与挑战
本地推理意味着数据不出设备、响应无延迟、离线可用,对隐私敏感与实时性要求高的场景意义重大。但端侧模型能力仍与云端旗舰存在差距,未来”端云协同”将是大模型落地的常态。想了解主流大模型怎么选,可参考2026年9月值得收藏的AI效率工具盘点;AI 编程协作也在走向多智能体化,Cursor Projects 已支持一个协调智能体调度数千个子智能体。更多前沿动态欢迎关注AI科技热点栏目。
常见问题(FAQ)
2026 年 10 月,宏碁、联想等 6 家 OEM 厂商的产品将同步出货。
DGX Spark 定位开发者工作站,RTX Spark 面向消费级与轻量 AI PC,两者共用 Blackwell 架构与统一内存理念,但定位、规模与价格不同。
千亿参数级模型建议 128GB 统一内存起步;AMD Gorgon Halo 的 192GB 可支撑 3000 亿参数模型本地运行;百亿级模型 32-64GB 即可流畅运行。
参考来源:IFA 2026 相关报道(IT之家、钛媒体、新浪科技)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...